이번 단원에서는 여러 개의 데이터가 주어졌을 때 그 데이터를 가장 잘 설명하는 하나의 직선을 찾는 방법을 알아본다.
예를 들어 실험을 통해 다음과 같은 데이터를 얻었다고 하자.
실제 측정값에는 오차가 있기 때문에 모든 점을 정확히 지나는 직선을 그리는 것은 일반적으로 불가능하다.
따라서 모든 데이터와의 오차를 종합적으로 고려하여 가장 잘 맞는 직선을 찾는다.
데이터
↓
평균·분산·표준편차
↓
Regression이란?
↓
Residual(잔차)
↓
Least Squares
↓
최적의 직선 y = a₀ + a₁x
↓
SSE · R² · Standard Error
↓
Residual Analysis
↓
비선형 모델의 Linearization
↓
Python 구현
01. Curve Fitting이란?
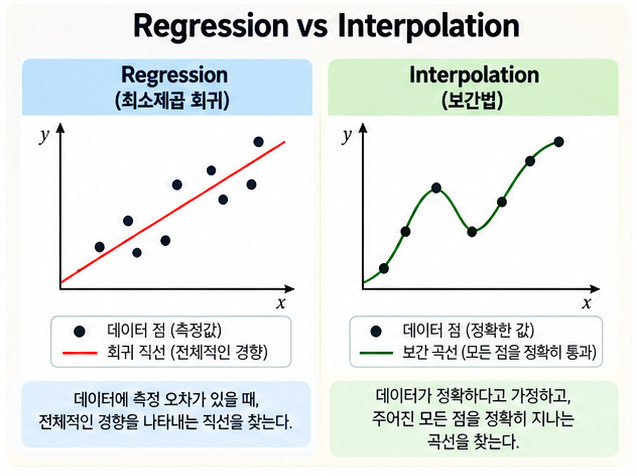
Curve Fitting은 여러 개의 데이터에 적절한 곡선이나 직선을 맞추는 과정이다.
크게 두 가지 접근 방법으로 나눌 수 있다.
| 방법 | 언제 사용하는가? | 특징 |
|---|---|---|
| Regression | 데이터에 측정오차나 Noise가 존재 | 전체적인 데이터의 경향을 나타내는 곡선을 찾음 |
| Interpolation | 데이터가 정확하다고 가정 | 주어진 데이터 점들을 정확히 통과 |
Regression → 데이터의 경향을 찾는다.
Interpolation → 데이터 점을 정확히 통과한다.
02. 회귀 전에 알아야 할 기초 통계
회귀분석을 이해하려면 데이터의 중심과 퍼짐 정도를 나타내는 몇 가지 기본 통계량을 알고 있어야 한다.
평균 Mean
n개의 데이터가 있을 때 표본평균은
이다.
즉 모든 데이터를 더한 뒤 데이터 개수로 나눈 값이다.
중앙값 Median
데이터를 크기순으로 정렬했을 때 가운데 위치하는 값이다.
평균과 달리 매우 크거나 작은 이상치(outlier)의 영향을 비교적 적게 받는다.
표본분산과 표본표준편차
평균만으로는 데이터가 얼마나 퍼져 있는지 알 수 없다.
그래서 각 데이터가 평균에서 얼마나 떨어져 있는지를 이용한다.
이를 Total Corrected Sum of Squares라고 한다.
표본분산은
이고, 표본표준편차는
이다.
평균 → 데이터의 중심
표준편차 → 데이터가 평균 주변에서 얼마나 퍼져 있는가
03. Histogram과 Normal Distribution
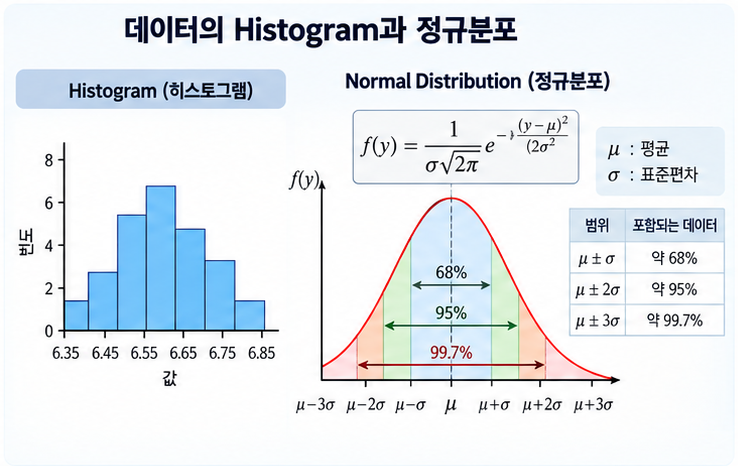
Histogram은 데이터를 여러 구간으로 나누어 각 구간에 데이터가 몇 개 존재하는지 나타낸 그래프이다.
이를 통해 다음과 같은 정보를 쉽게 확인할 수 있다.
- 데이터가 어느 위치에 집중되어 있는가?
- 얼마나 넓게 퍼져 있는가?
- 분포가 대칭적인가?
- 이상치가 존재하는가?
Normal Distribution
많은 자연현상과 측정값은 평균 주변에 데이터가 많이 모이고 양쪽으로 갈수록 데이터가 줄어드는 종 모양의 분포를 보인다.
이를 Normal Distribution(정규분포)이라고 한다.
여기서
σ → 표준편차
정규분포에서는 대략
| 범위 | 포함되는 데이터 |
|---|---|
| μ ± σ | 약 68% |
| μ ± 2σ | 약 95% |
| μ ± 3σ | 약 99.7% |
이를 흔히 68–95–99.7 Rule이라고 한다.
04. Straight-Line Linear Regression
이제 본격적으로 직선 회귀를 살펴보자.
데이터에 맞추고 싶은 직선 모델을
라고 하자.
a₁ → 기울기(slope)
ŷ → 회귀모델이 예측한 y값
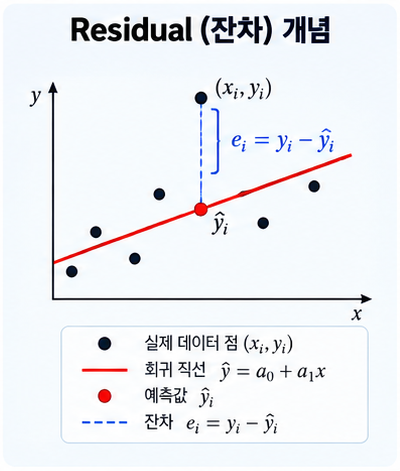
하지만 실제 측정값 yᵢ와 모델이 예측한 ŷᵢ는 일반적으로 정확히 같지 않다.
여기서 eᵢ를 Residual(잔차)이라고 한다.
즉 잔차는 실제 데이터와 회귀 직선 사이의 세로 거리이다.
05. 어떤 직선이 가장 좋은 직선일까?
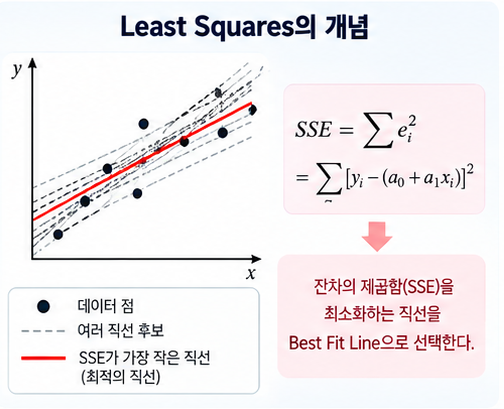
그렇다면 여러 개의 직선 중 어떤 직선을 Best Fit이라고 해야 할까?
단순히 잔차를 모두 더하는 방법을 생각할 수 있다.
하지만 양의 오차와 음의 오차가 서로 상쇄될 수 있기 때문에 좋은 기준이 아니다.
절댓값을 이용하는 방법도 있지만, 고전적인 선형 최소제곱 회귀에서는 다음 기준을 사용한다.
즉
를 최소로 만드는 a₀와 a₁을 찾는다.
각 데이터의 오차
↓
오차를 제곱
↓
전부 더함
↓
그 값이 가장 작아지는 직선을 선택
06. 왜 오차를 제곱할까?
오차를 제곱하면 몇 가지 장점이 있다.
- 양수와 음수 오차가 서로 상쇄되지 않는다.
- 큰 오차에 더 큰 페널티를 준다.
- 미분이 가능하여 최적의 직선을 수학적으로 계산하기 쉽다.
따라서 Least Squares에서는
를 최소화한다.
07. 최적의 a₀와 a₁ 구하기
SSE가 최소가 되는 지점에서는 a₀와 a₁에 대한 편미분이 0이 된다.
이를 정리하면 다음 Normal Equations을 얻는다.
두 방정식을 풀면 최적의 기울기와 절편을 얻을 수 있다.
먼저 기울기 a₁을 구하고
a₀ = ȳ − a₁x̄
를 이용하여 절편을 구한다.
08. 계산 예제
다음 데이터에 직선을 맞춘다.
계산 결과
를 얻는다.
따라서 최적의 직선은
이다.
수학적으로 가장 잘 맞는 직선이라고 해서 항상 물리적으로 올바른 모델이라는 뜻은 아니다.
이 예제에서는 x = 0일 때 예측값이 −234.29가 되는데, 물리적으로 의미가 없는 값일 수 있다.
따라서 실제 현상을 분석할 때는 그래프와 물리적 의미도 함께 확인해야 한다.
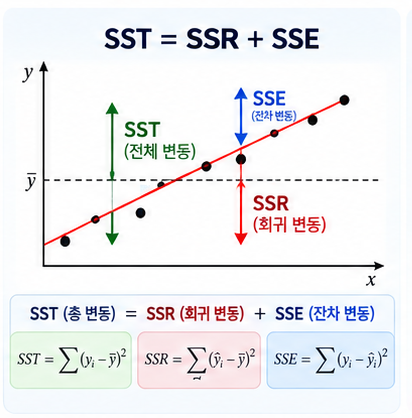
09. 회귀모델의 오차 SSE
모델이 얼마나 많은 오차를 가지고 있는지는 SSE(Error Sum of Squares)로 나타낼 수 있다.
SSE가 작을수록 실제 데이터와 회귀직선 사이의 차이가 작다.
한편 데이터 전체의 변동량은
로 나타낸다.
그리고 회귀모델이 설명한 변동량을 SSR이라고 하면
관계가 성립한다.
10. R² : Coefficient of Determination
회귀분석에서 자주 보는 값이 R²(결정계수)이다.
SST = SSR + SSE이므로
라고도 쓸 수 있다.
예제)
즉 이 직선 모델이 데이터 변동의 약 88%를 설명한다고 해석할 수 있다.
| R² | 의미 |
|---|---|
| 1에 가까움 | 모델이 데이터 변동을 많이 설명 |
| 0에 가까움 | 모델의 설명력이 낮음 |
R²는 모델 평가의 한 가지 지표일 뿐이다.
잔차에 일정한 패턴이 존재하거나 이상치가 심하다면 R²가 높더라도 모델이 적절하지 않을 수 있다.
11. Standard Error of the Estimate
회귀직선 주변에 데이터가 얼마나 퍼져 있는지를 나타내는 값이 Standard Error of the Estimate이다.
분모가 n − 2인 이유는 a₀와 a₁ 두 개의 매개변수를 데이터로부터 추정했기 때문에 자유도 2개를 사용했기 때문이다.
강의 예제에서는
을 얻는다.
R² → 모델이 전체 변동을 얼마나 설명하는가?
sₑ → 실제 데이터가 회귀직선 주변에서 얼마나 퍼져 있는가?
12. Residual Analysis가 중요한 이유
좋은 회귀모델이라면 잔차가 특정한 패턴 없이 무작위로 흩어져 있어야 한다.
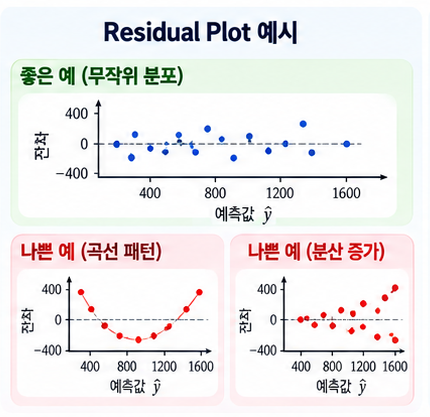
예를 들어 잔차 그래프가 U자 모양을 보인다면 직선 대신 곡선 모델이 필요할 가능성이 있다.
또 x가 증가할수록 잔차의 폭이 점점 커진다면 오차의 분산이 일정하지 않은 heteroscedasticity(이분산성)가 의심된다.
데이터
↓
직선 회귀
↓
R² 확인
↓
잔차 그래프 확인
↓
잔차에 체계적인 패턴이 없는지 확인
13. R²만 믿으면 안 되는 이유
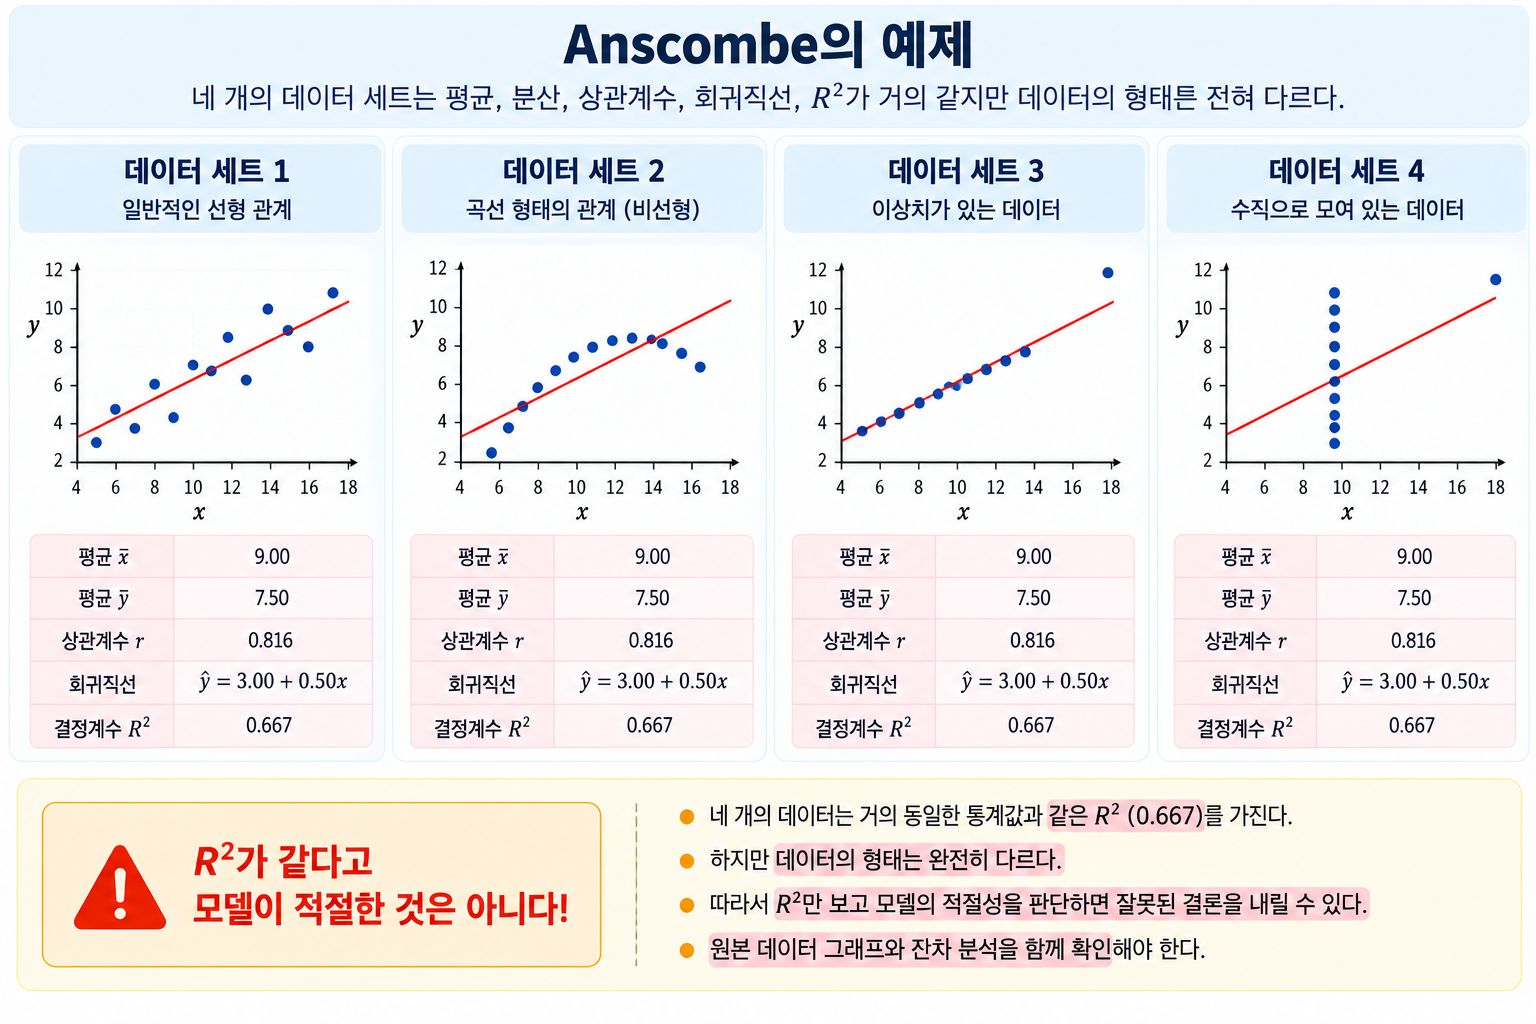
유명한 Anscombe's Quartet 예제를 통해 R²의 한계를 보여준다.
서로 전혀 다르게 생긴 네 데이터 세트가 거의 동일한 회귀직선과 동일한 R²를 가질 수 있다.
① 원본 데이터 그래프
② R²
③ Residual Plot
을 함께 확인하는 것이 중요하다.
14. 비선형 관계를 Linear Regression으로 풀기
모든 데이터가 직선 관계를 가지는 것은 아니다.
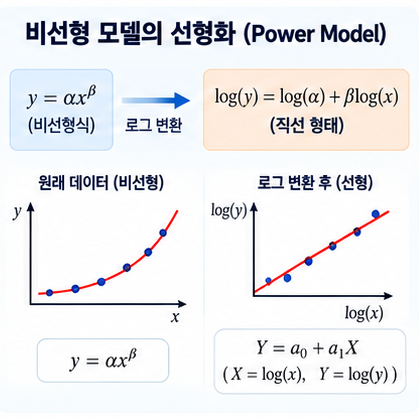
예를 들어
와 같은 Power Model을 생각해보자.
이 식 자체는 x에 대해 선형이 아니기 때문에 그대로 직선 회귀를 적용할 수 없다.
하지만 양변에 로그를 취하면
가 된다.
여기서
라고 두면
라는 직선 형태가 된다.
비선형식
y = αxβ
↓ log 변환
log(y) = log(α) + βlog(x)
↓ 직선회귀
기울기 → β
절편 → log(α)
15. Power Model 예제
예제) 번지점퍼의 힘과 속도 데이터를 이용하여
형태의 모델을 구한다.
로그 변환 후 선형회귀를 수행하면
를 얻는다.
원래 식으로 다시 변환하면
가 된다.
지수가 약 1.9842이므로 2에 매우 가깝다.
따라서 물리적으로 예상했던
형태와 매우 유사하며,
로 해석할 수 있다.
16. Python으로 Straight-Line Regression
예제의 데이터를 Python으로 계산해보자.
import numpy as np

x = np.array([10., 20., 30., 40., 50., 60., 70., 80.])
y = np.array([25., 70., 380., 550., 610., 1220., 830., 1450.])

n = len(x)

x_mean = np.mean(x)
y_mean = np.mean(y)

a1 = (
    n * np.sum(x * y)
    - np.sum(x) * np.sum(y)
) / (
    n * np.sum(x**2)
    - np.sum(x)**2
)

a0 = y_mean - a1 * x_mean

print("Intercept =", a0)
print("Slope =", a1)
결과는 약
이다.
17. Python으로 R²와 Standard Error 계산하기
y_hat = a0 + a1 * x

residuals = y - y_hat

SSE = np.sum(residuals**2)
SST = np.sum((y - y_mean)**2)

R_squared = 1 - SSE / SST
standard_error = np.sqrt(SSE / (n - 2))

print("R-squared =", R_squared)
print("Standard error =", standard_error)
약
를 얻는다.
18. NumPy polyfit으로 더 간단하게 계산하기
NumPy에서는 직접 공식을 구현하지 않아도 np.polyfit()을 이용할 수 있다.
import numpy as np

x = np.array([10., 20., 30., 40., 50., 60., 70., 80.])
y = np.array([25., 70., 380., 550., 610., 1220., 830., 1450.])

p = np.polyfit(x, y, 1)

slope = p[0]
intercept = p[1]

print("Slope =", slope)
print("Intercept =", intercept)
여기서 `1`은 1차 다항식, 즉 직선을 의미한다.
np.polyfit(x, y, 1)의 결과는
[기울기, 절편]
순서이다.
즉 p[0] = a₁, p[1] = a₀이다.
19. polyval로 예측하기
polyfit으로 얻은 계수 p를 이용하면 np.polyval()로 원하는 x에서의 예측값을 계산할 수 있다.
x_new = np.array([20., 45., 70.])

y_pred = np.polyval(p, x_new)

print(y_pred)
즉
의 계산을 간단하게 수행할 수 있다.
20. 회귀직선과 Residual Plot 그리기
import numpy as np
import matplotlib.pyplot as plt

x = np.array([10., 20., 30., 40., 50., 60., 70., 80.])
y = np.array([25., 70., 380., 550., 610., 1220., 830., 1450.])

p = np.polyfit(x, y, 1)

x_line = np.linspace(0, 90, 100)
y_line = np.polyval(p, x_line)

y_hat = np.polyval(p, x)
residuals = y - y_hat

plt.scatter(x, y)
plt.plot(x_line, y_line)
plt.xlabel("x")
plt.ylabel("y")
plt.title("Straight-Line Regression")
plt.show()

plt.scatter(y_hat, residuals)
plt.axhline(0)
plt.xlabel("Predicted y")
plt.ylabel("Residual")
plt.title("Residuals vs. Fits")
plt.show()
첫 번째 그래프에서는 데이터와 회귀직선을, 두 번째 그래프에서는 잔차의 패턴을 확인할 수 있다.
21. Python에서 표본표준편차를 계산할 때 주의
NumPy의 기본 np.std()는 분모로 n을 사용하는 모집단 표준편차 방식이다.
이번 강의에서 정의한 표본표준편차는 분모가 n − 1이므로 Python에서는 다음과 같이 작성하는 것이 정확하다.
sample_std = np.std(y, ddof=1)
sample_var = np.var(y, ddof=1)

print("Sample standard deviation =", sample_std)
print("Sample variance =", sample_var)
np.std(data)
→ 분모 n
np.std(data, ddof=1)
→ 분모 n − 1
→ 표본표준편차
22. Linear Regression의 기본 가정
Least-Squares Linear Regression을 사용할 때는 몇 가지 기본 가정이 존재한다.
② 각 y값의 오차는 서로 독립적이라고 가정한다.
③ 오차의 분산이 일정하다고 가정한다.
④ 통계적 추론을 위해서는 오차의 정규성 가정도 중요하다.
따라서 단순히 직선을 계산하는 것에서 끝나는 것이 아니라 잔차 그래프를 확인하여 이러한 가정이 심하게 깨지지 않는지도 확인해야 한다.
23. 전체 흐름 정리
[ 핵심 정리 ]
Regression은 데이터의 전체적인 경향을 찾고, Interpolation은 데이터 점을 정확히 통과한다.
② Straight-Line Model
ŷ = a₀ + a₁x
③ Residual
eᵢ = yᵢ − ŷᵢ
④ Least Squares
SSE = Σeᵢ²를 최소화한다.
⑤ Slope
a₁ = nΣxᵢyᵢ − (Σxᵢ)(Σyᵢ) nΣxᵢ² − (Σxᵢ)²
⑥ Intercept
a₀ = ȳ − a₁x̄
⑦ Sum of Squares
SST = SSR + SSE
⑧ Coefficient of Determination
R² = 1 − SSE SST
⑨ Standard Error
sₑ = √ SSE n − 2
⑩ Residual Analysis
좋은 모델이라면 잔차에 뚜렷한 패턴이 없어야 한다.
⑪ R² 주의
R²가 높다고 해서 반드시 적절한 모델인 것은 아니다. 원본 데이터와 잔차 그래프도 확인해야 한다.
⑫ Linearization
y = αxᵝ라면 로그를 취해 log(y) = log(α) + βlog(x)로 바꿀 수 있다.
⑬ Python
np.polyfit(x, y, 1) → 직선 계수 계산
np.polyval(p, x) → 모델 예측값 계산
'컴퓨터과학 > 수치해석 (Numerical Analysis)' 카테고리의 다른 글
| [수치해석] 9강 | 반복법(Iterative Methods)을 이용한 연립방정식 풀이 (0) | 2026.10.17 |
|---|---|
| [수치해석] 8강 | Matrix Inverse and Condition역행렬과 행렬의 조건수 (0) | 2026.10.17 |
| [수치해석] 7강 - LU Factorization (0) | 2026.10.15 |
| [수치해석] 6강 - Gauss Elimination (0) | 2026.10.12 |
| [수치해석] 5강 | Linear Algebraic Equations and Matrices (0) | 2026.10.12 |


댓글